Видобування тексту (OCR) і переклад
ZunShot використовує рушій OCR, вбудований у Windows. Розпізнавання виконується локально на вашому комп’ютері, нічого нікуди не надсилається. Переклад необов’язковий, і для нього надсилається лише розпізнаний текст.
Як це зробити
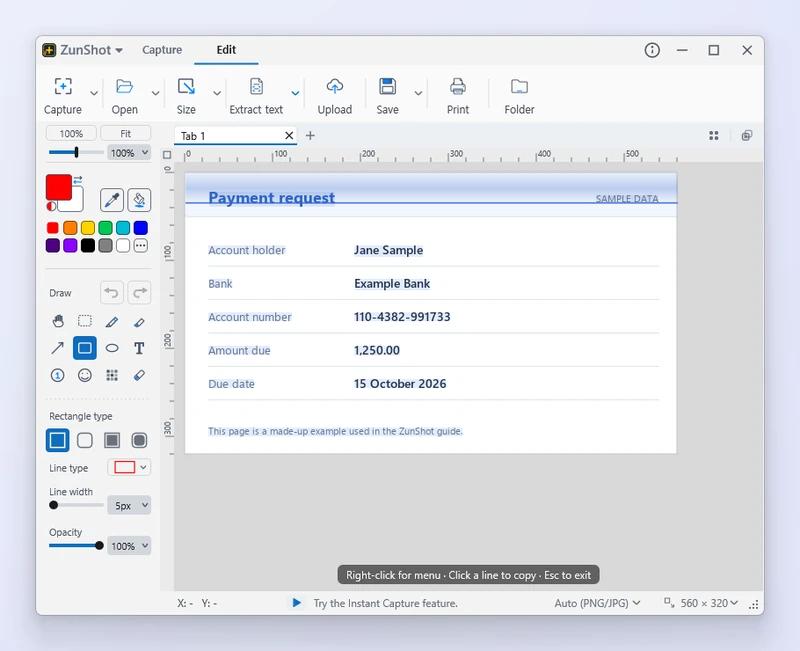
- Відкрийте знімок у редакторі. Або виділіть область у режимі миттєвого захоплення й натисніть Видобути текст.
- Виберіть «Видобути текст (OCR)». Виділіть область із текстом або використайте все зображення.
- Скопіюйте або збережіть. Скопіюйте текст до буфера обміну або збережіть його як текстовий файл. Якщо якийсь символ розпізнано неправильно, спочатку виправте його.
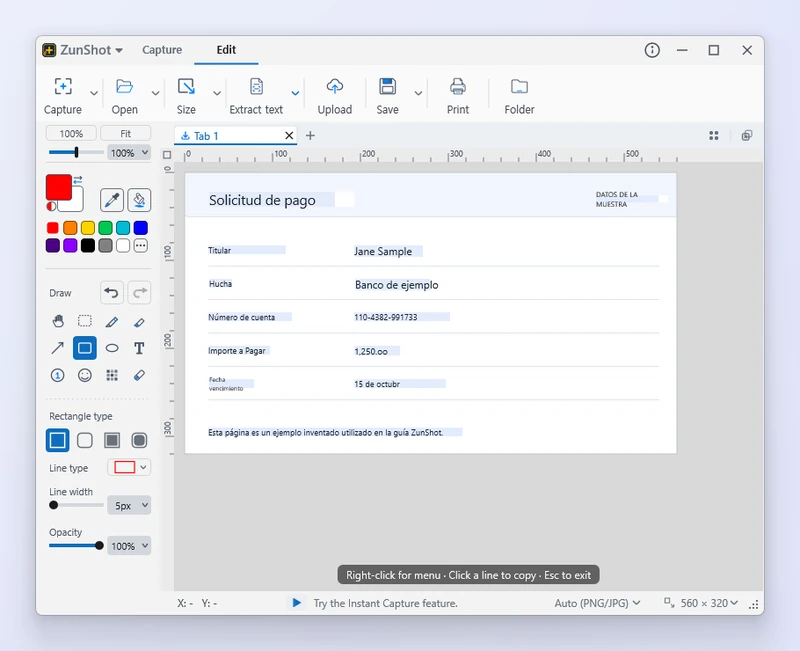
- Перекладіть зображення. Виберіть Перекласти зображення та вкажіть мову перекладу. Кожен розпізнаний рядок надсилається на переклад, а результат малюється поверх початкового тексту, тому довга сторінка потребує кількох секунд. Натисніть Esc, щоб скасувати, або знову виберіть мову оригіналу, щоб повернути початковий текст.
Поради
- Мови розпізнавання встановлюються в розділі «Налаштування > Мова» > Встановити мови OCR…. Windows потрібна сама мова та її компоненти введення тексту, а не лише мова інтерфейсу.
- Точність зростає, якщо джерело чітке, а мову вибрано правильно. Обріжте зайві частини й уникайте сильно стиснених зображень.
- Для перекладу використовується служба MyMemory. Необов’язкова адреса електронної пошти підвищує добовий ліміт і надсилається, лише якщо ви її вказали.
Поширені запитання
OCR видав беззмістовні символи.
Вибрана мова не відповідає тексту. Виберіть правильну мову або спочатку встановіть її.
Чи надсилається моє зображення кудись для OCR?
Ні. OCR виконує Windows на вашому комп’ютері. Лише переклад надсилає розпізнаний текст.