«Извлечь текст» выдаёт неверные символы или ничего не находит
ZunShot использует модуль OCR, встроенный в Windows. Результат зависит от установленного языка распознавания и от качества изображения.
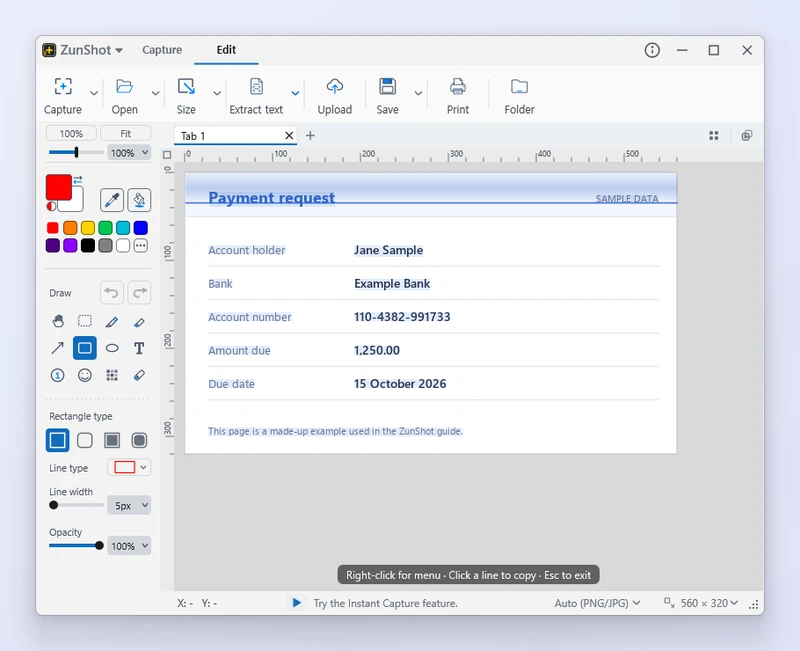
Бессмысленные символы
Язык распознавания не соответствует тексту. Выберите нужный язык на панели извлечения текста. Если его нет в списке, установите его: Настройки > Язык > Установить языки OCR….
Язык установлен, но OCR по-прежнему не работает
Windows регистрирует модуль OCR только тогда, когда для языка установлен компонент Базовый ввод, а не только язык интерфейса. Откройте Параметры Windows > Время и язык > Язык и регион, выберите язык и добавьте компонент «Базовый ввод».
Ничего не распознаётся
- Увеличьте снимок так, чтобы высота текста была не менее примерно 20 пикселей, и повторите извлечение.
- Обрежьте фотографии и значки вокруг текста.
- Сильно сжатый или стилизованный текст может не распознаваться.
Подробнее в руководстве: Извлечение текста (OCR).
Краткие ответы
- Почему OCR выдаёт бессмысленные символы?
- Выбранный язык не соответствует тексту. Выберите или установите нужный язык OCR в Windows.
- Загружается ли моё изображение в облако для OCR?
- Нет. Распознавание выполняется локально на вашем компьютере с помощью модуля OCR Windows.
Похожие вопросы
- [Чёрный снимок] Снимок получается чёрным или пустым
- [Клавиши] Сочетание клавиш не работает / нет клавиши Scroll Lock / PrtScn открывает «Ножницы»
- [Буфер обмена] Копирование не удаётся или вставленное изображение получает белый фон
- [Прокрутка] Захват с прокруткой останавливается раньше времени или склеивается со смещением
- [Окно] Окно ZunShot исчезло
- [Обновление] Как обновить ZunShot?
- [Удаление] Как удалить ZunShot и его данные?
- [Поддержка] Как связаться с поддержкой ZunShot?