« Extraire le texte » renvoie des caractères erronés ou rien du tout
ZunShot utilise le moteur OCR intégré à Windows. Les résultats dépendent de la langue de reconnaissance installée et de la qualité de l'image.
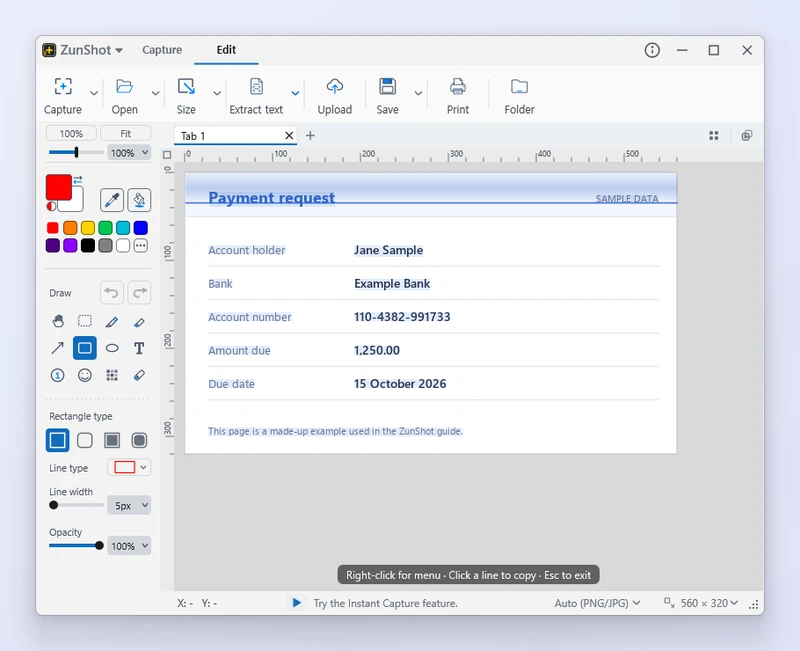
Caractères incohérents
La langue de reconnaissance ne correspond pas au texte. Choisissez la bonne langue dans le panneau d'extraction. Si elle ne figure pas dans la liste, installez-la : Paramètres > Langue > Installer des langues OCR….
La langue est installée, mais l'OCR échoue toujours
Windows n'enregistre le moteur OCR que lorsque la fonctionnalité Saisie de base de la langue est installée, et pas seulement la langue d'affichage. Ouvrez Paramètres Windows > Heure et langue > Langue et région, sélectionnez la langue, puis ajoutez la Saisie de base.
Rien n'est reconnu
- Agrandissez la capture pour que le texte mesure au moins 20 pixels de haut environ, puis relancez l'extraction.
- Rognez les photos et les icônes qui entourent le texte.
- Un texte fortement compressé ou stylisé peut ne pas être lisible.
Pour en savoir plus, consultez le guide : Extraire le texte (OCR).
Réponses rapides
- Pourquoi l'OCR produit-il des caractères incohérents ?
- La langue sélectionnée ne correspond pas au texte. Choisissez ou installez la bonne langue OCR de Windows.
- Mon image est-elle envoyée sur Internet pour l'OCR ?
- Non. La reconnaissance s'effectue localement sur votre PC, avec le moteur OCR de Windows.
FAQ associées
- [Image noire] Ma capture est noire ou vide
- [Raccourci] Un raccourci ne fonctionne pas / pas de touche Scroll Lock / PrtScn ouvre l'Outil Capture d'écran
- [Presse-papiers] La copie échoue ou l'image collée a un fond blanc
- [Défilement] La capture avec défilement s'arrête trop tôt ou semble mal alignée
- [Fenêtre] La fenêtre ZunShot a disparu
- [Mise à jour] Comment mettre à jour ZunShot ?
- [Désinstallation] Comment désinstaller ZunShot et supprimer ses données ?
- [Assistance] Comment contacter l'assistance ZunShot ?