“Extrair o texto” retorna caracteres errados ou nada
O ZunShot usa o mecanismo de OCR integrado ao Windows. Os resultados dependem do idioma de reconhecimento instalado e da qualidade da imagem.
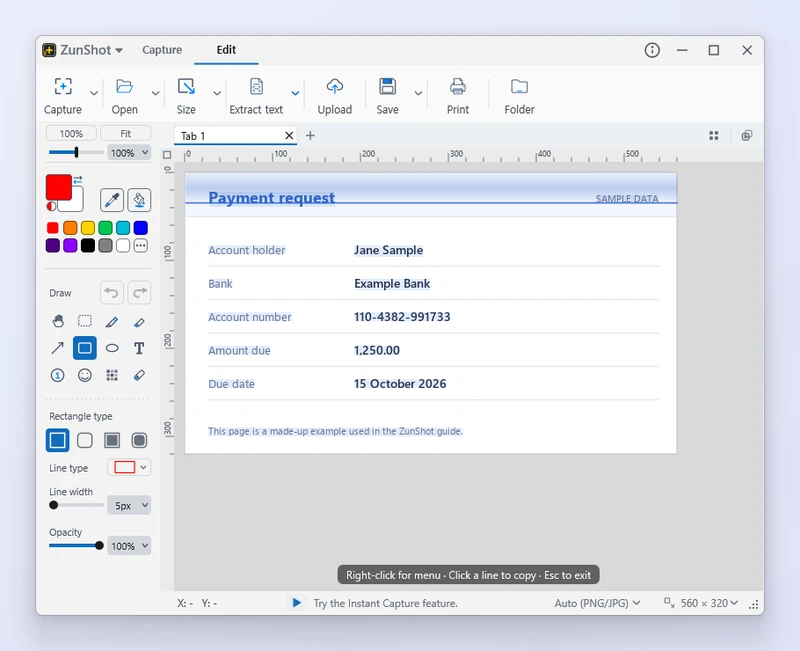
Caracteres sem sentido
O idioma de reconhecimento não corresponde ao texto. Escolha o idioma correto no painel de extração. Se ele não estiver na lista, instale-o: Configurações > Idioma > Instalar idiomas OCR….
O idioma está instalado, mas o OCR continua falhando
O Windows só registra o mecanismo de OCR quando o recurso Digitação básica do idioma está instalado, e não apenas o idioma de exibição. Abra Configurações do Windows > Hora e idioma > Idioma e região, escolha o idioma e adicione a Digitação básica.
Nada é reconhecido
- Amplie a captura para que o texto tenha pelo menos cerca de 20 pixels de altura e extraia novamente.
- Corte as fotos e os ícones ao redor do texto.
- Um texto muito comprimido ou estilizado pode não ser legível.
Mais informações no guia: Extrair o texto (OCR).
Respostas rápidas
- Por que o OCR produz caracteres sem sentido?
- O idioma selecionado não corresponde ao texto. Escolha ou instale o idioma OCR correto do Windows.
- Minha imagem é enviada para algum servidor para o OCR?
- Não. O reconhecimento é feito no seu PC, com o mecanismo de OCR do Windows.
FAQs relacionadas
- [Tela preta] Minha captura está preta ou vazia
- [Atalho] Um atalho não funciona / sem tecla Scroll Lock / PrtScn abre a Ferramenta de Captura
- [Área de transferência] A cópia falha ou a imagem colada fica com fundo branco
- [Rolagem] A captura com rolagem para antes do fim ou fica desalinhada
- [Janela] A janela do ZunShot desapareceu
- [Atualização] Como atualizo o ZunShot?
- [Desinstalar] Como desinstalo o ZunShot e removo seus dados?
- [Suporte] Como entro em contato com o suporte do ZunShot?