«Видобути текст» повертає неправильні символи або нічого
ZunShot використовує рушій OCR, вбудований у Windows. Результат залежить від встановленої мови розпізнавання та якості зображення.
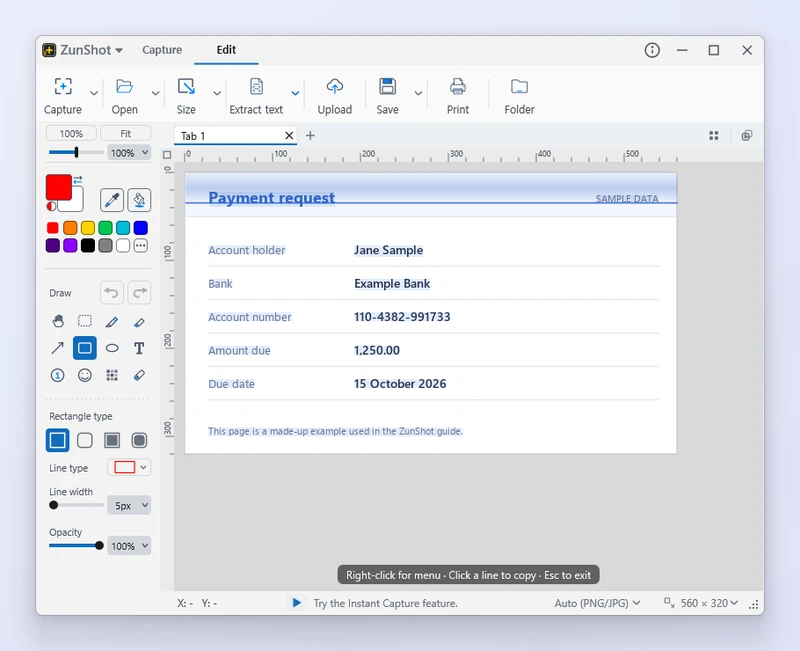
Безглузді символи
Мова розпізнавання не відповідає мові тексту. Виберіть потрібну мову на панелі видобування тексту. Якщо її немає у списку, встановіть її: Налаштування > Мова > Встановити мови OCR….
Мову встановлено, але OCR однаково не працює
Windows реєструє рушій OCR лише тоді, коли для мови встановлено компонент Базове введення, а не тільки мову інтерфейсу. Відкрийте «Параметри» Windows > «Час і мова» > «Мова та регіон», виберіть мову й додайте «Базове введення».
Нічого не розпізнано
- Збільште масштаб знімка так, щоб висота тексту становила щонайменше приблизно 20 пікселів, і видобудьте текст ще раз.
- Обріжте фотографії та значки навколо тексту.
- Сильно стиснутий або стилізований текст може не розпізнаватися.
Докладніше в посібнику: Видобути текст (OCR).
Короткі відповіді
- Чому OCR видає безглузді символи?
- Вибрана мова не відповідає мові тексту. Виберіть або встановіть потрібну мову OCR у Windows.
- Чи надсилається моє зображення кудись для OCR?
- Ні. Розпізнавання виконується локально на вашому комп’ютері за допомогою рушію OCR Windows.
Пов’язані запитання
- [Чорний екран] Знімок чорний або порожній
- [Клавіші] Сполучення клавіш не працює / немає Scroll Lock / PrtScn відкриває «Засіб захоплення фрагментів»
- [Буфер обміну] Копіювання не вдається або вставлене зображення має білий фон
- [Прокручування] Захоплення з прокручуванням зупиняється зарано або зшивається зі зсувом
- [Вікно] Вікно ZunShot зникло
- [Оновлення] Як оновити ZunShot?
- [Видалення] Як видалити ZunShot і його дані?
- [Підтримка] Як звернутися до служби підтримки ZunShot?