«Extraer el texto» devuelve caracteres incorrectos o nada
ZunShot utiliza el motor OCR integrado en Windows. Los resultados dependen del idioma de reconocimiento instalado y de la calidad de la imagen.
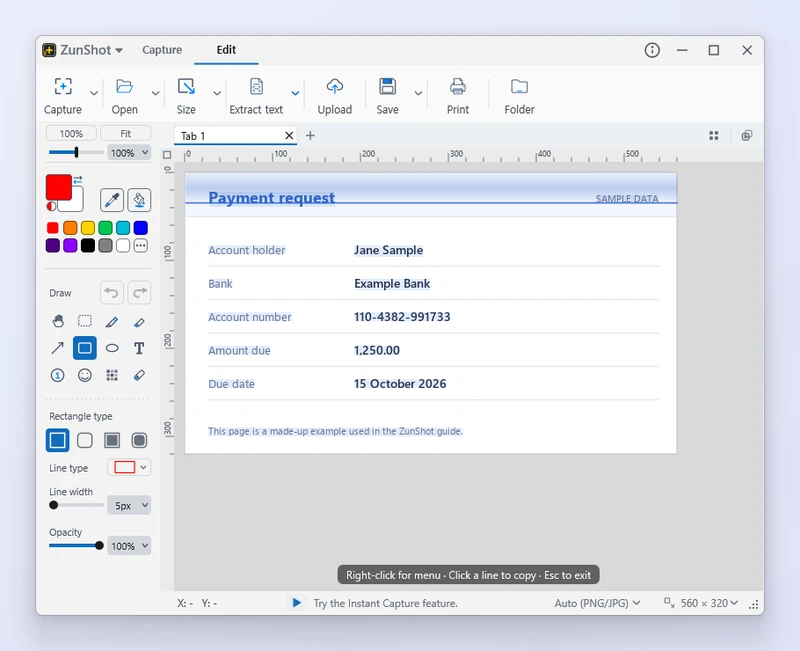
Caracteres sin sentido
El idioma de reconocimiento no coincide con el del texto. Elija el idioma correcto en el panel de extracción. Si no aparece en la lista, instálelo: Configuración > Idioma > Instalar idiomas OCR….
El idioma está instalado, pero el OCR sigue fallando
Windows registra el motor OCR solo cuando está instalada la característica Escritura básica del idioma, no solo el idioma para mostrar. Abra Configuración de Windows > Hora e idioma > Idioma y región, elija el idioma y añada «Escritura básica».
No se reconoce nada
- Amplíe la captura para que el texto tenga al menos unos 20 píxeles de alto y vuelva a extraerlo.
- Recorte las fotos y los iconos que rodean el texto.
- Es posible que el texto muy comprimido o con un diseño muy estilizado no se pueda leer.
Más información en la guía: Extraer el texto (OCR).
Respuestas rápidas
- ¿Por qué el OCR devuelve caracteres sin sentido?
- El idioma seleccionado no coincide con el del texto. Elija o instale el idioma OCR de Windows adecuado.
- ¿Se sube mi imagen a algún servidor para el OCR?
- No. El reconocimiento se ejecuta en su propio PC con el motor OCR de Windows.
Preguntas frecuentes relacionadas
- [Negro] Mi captura sale en negro o vacía
- [Atajo] Un atajo no funciona / no tengo la tecla Scroll Lock / PrtScn abre Recortes
- [Portapapeles] La copia falla o la imagen pegada tiene fondo blanco
- [Desplazamiento] La captura con desplazamiento se detiene antes de tiempo o queda desalineada
- [Ventana] La ventana de ZunShot ha desaparecido
- [Actualizar] ¿Cómo actualizo ZunShot?
- [Desinstalar] ¿Cómo desinstalo ZunShot y elimino sus datos?
- [Soporte] ¿Cómo contacto con el soporte de ZunShot?